研究显示 AI 在临床试验论文审校中错误检出率远超人类同行评审
原标题:> AI now catches far more errors in clinical trial papers than human peer reviewers: all 15 models t...
85AI 研判分
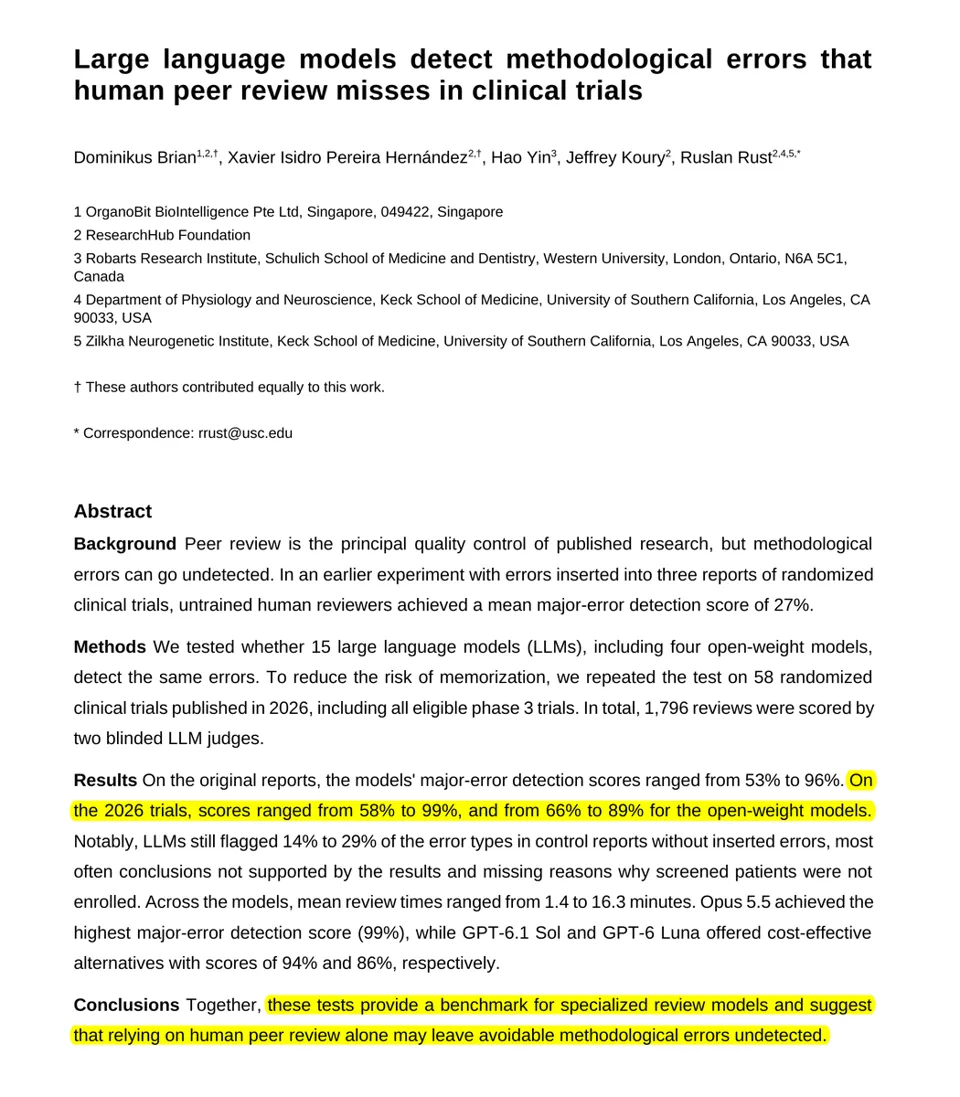
最新预印本研究表明,15 款主流大模型在检测临床试验论文植入错误方面的表现显著优于未经专门训练的人类同行评审员。所有测试模型的错误检出率在 53% 至 96% 之间,而人类平均仅为 27%,且 Claude Opus 5.5 得分最高达 99%。此外,AI 在处理文本与表格矛盾等关键语义错误上优势明显,并将单次审校时间从人类的数小时缩短至分钟级。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-29 00
AI 在临床试验论文中捕获的错误远多于人类同行评审员:所有受测的 15 个模型在植入错误上的得分介于 53% 至 96% 之间,而未受过训练的人类评审员平均得分仅为 27%。
这一结果在 2026 年发表的 58 项新试验中依然成立,说明这些模型并非仅仅是在回忆训练时见过的旧论文;Claude Opus 5.5 得分最高,达到 99%。
人类往往遗漏那些最能改变试验含义的错误,仅在 7% 的情况下能发现文本与表格之间的矛盾;此外,人类每次评审耗时 5 到 8.5 小时,而 AI 仅需 1.4 到 16.3 分钟。
↳ 引用 @rust_ruslan (Ruslan Rust): 本周关于期刊是否应禁止在同行评审中使用 AI 引发了大量争论。
实际上,我们在新的预印本论文中对此进行了测试,结果对我来说相当明确。
作为背景信息,我曾为大多数顶级期刊担任审稿人,并作为编辑评估过 1,000 份人类评审意见。我热爱阅读和评估科学研究。
TLDR(太长不看版):从现在起,我不会在没有 AI 辅助的情况下进行任何同行评审。对于临床试验,我甚至认为仅靠人类的评审是危险的 🧵