Rohan Paul (@rohanpaul_ai) · 2026/10/23 15:59:49
哈佛研究:AI 论文评审在盲测中全面超越人类专家
出处作者 / 发布主体:Rohan Paul (@rohanpaul_ai)原标题:Massive. New Harvard study finds that AI-written paper reviews now beat the best human peer reviews ...
78AI 研判分
核心综述
哈佛大学最新研究显示,Claude Opus 4.8 生成的论文评审在多项指标上优于顶级人类同行评审。通过 GPT-5.5 与期刊编辑的盲测评估,AI 评审被选中率高达 87%,且事实错误率显著低于人类(5.5% vs 15.9%),表明 AI 已具备执行首轮完整评审的能力。
报道全文原始报道全文
Rohan Paul (@rohanpaul_ai) · 2026-10-23 07
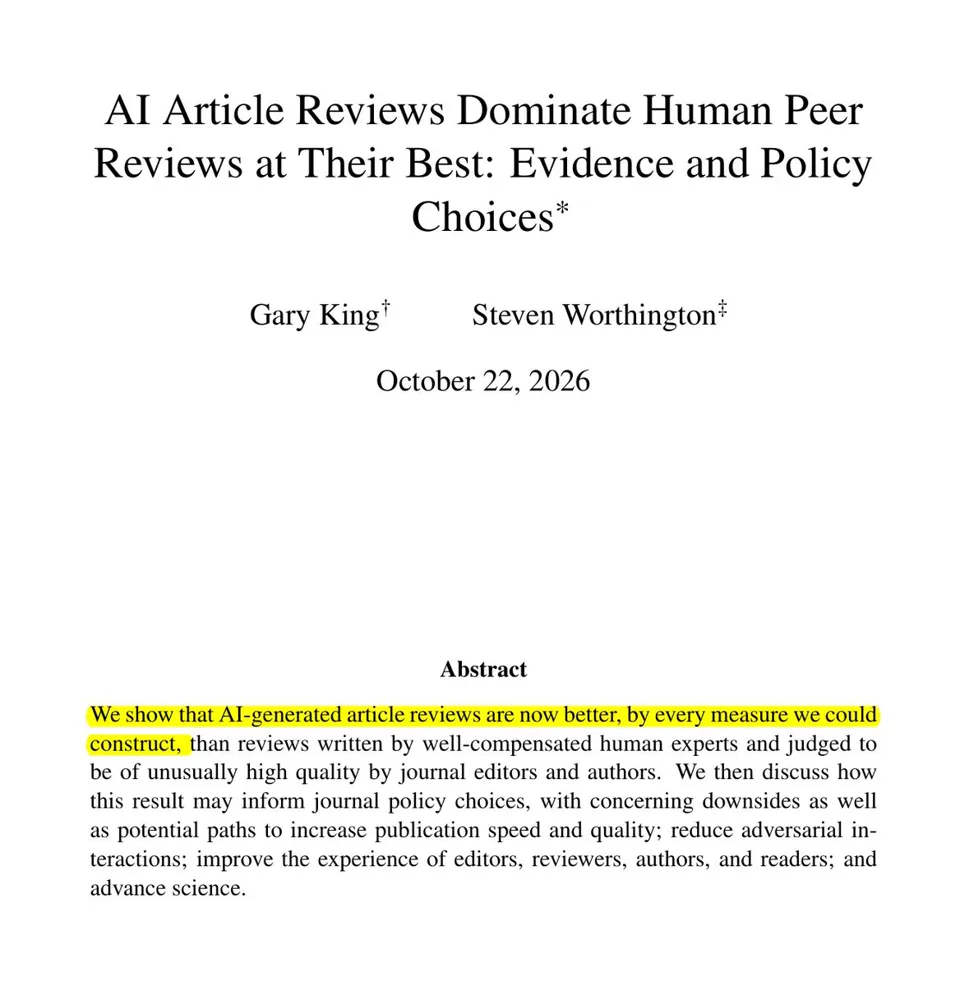
重磅消息。哈佛大学最新研究发现,在作者测试的所有指标上,AI 生成的论文评审如今已超越最优秀的人类同行评审。
同行评审过程缓慢,且经常遗漏错误。早期的研究结论认为,AI 应仅作为人类评审员的辅助工具,而非替代者。
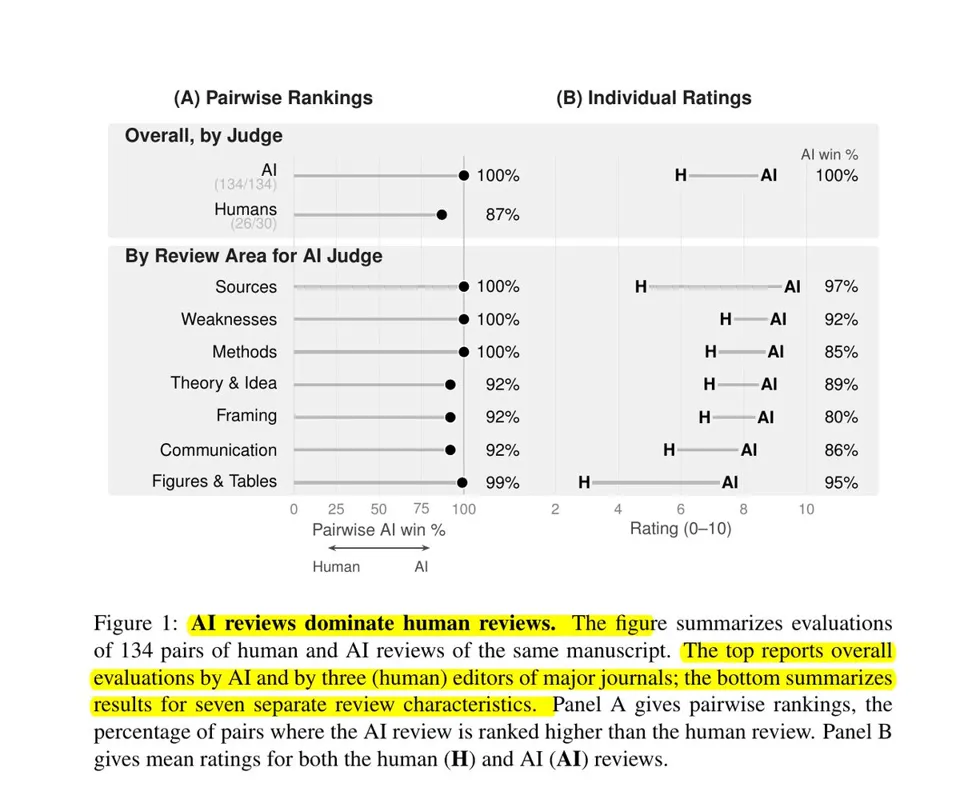
他们使用了来自 rapidPeer(一项向专家评审员支付高额报酬的哈佛服务)的 134 份评审意见。Claude Opus 4.8 对同样的 1124 篇论文进行了评审,随后由 GPT-5.5 以及三位前期刊编辑对这些成对的评审结果进行盲测评判。
在所有 132 组得出明确结论的对比中,GPT-5.5 均选择了 AI 生成的评审;而在编辑们的选择中,这一比例也高达 87%。此外,AI 评审中关于论文的论断仅有 5.5% 是错误的,相比之下,人类评审的错误率为 15.9%。
依赖专家评审的团队现在可以让 AI 完成首轮全面评审,并保留人类专家负责最终决策。