Thinking Machines 发布 Inkling 2 Small 稀疏 MoE 模型
Thinking Machines Lab 发布 Inkling 2 Small,总参数 594B 的混合专家模型,每个 token 仅激活 17B 参数,在 48 层中从 384 个专家里路由 8 个,并接入 292M 视觉编码器支持图像输入。其在 Artificial Analysis 智能指数上得 31 分,SWE-Bench Pro v2 达 86.3%,但推理速度偏慢、Terminal-Bench 仅 13.1%,目前权重闭源,计划安全测试后以 Apache 2.0 开放。
报道正文
▲ Marktechpost AI · 2026-11-06 04
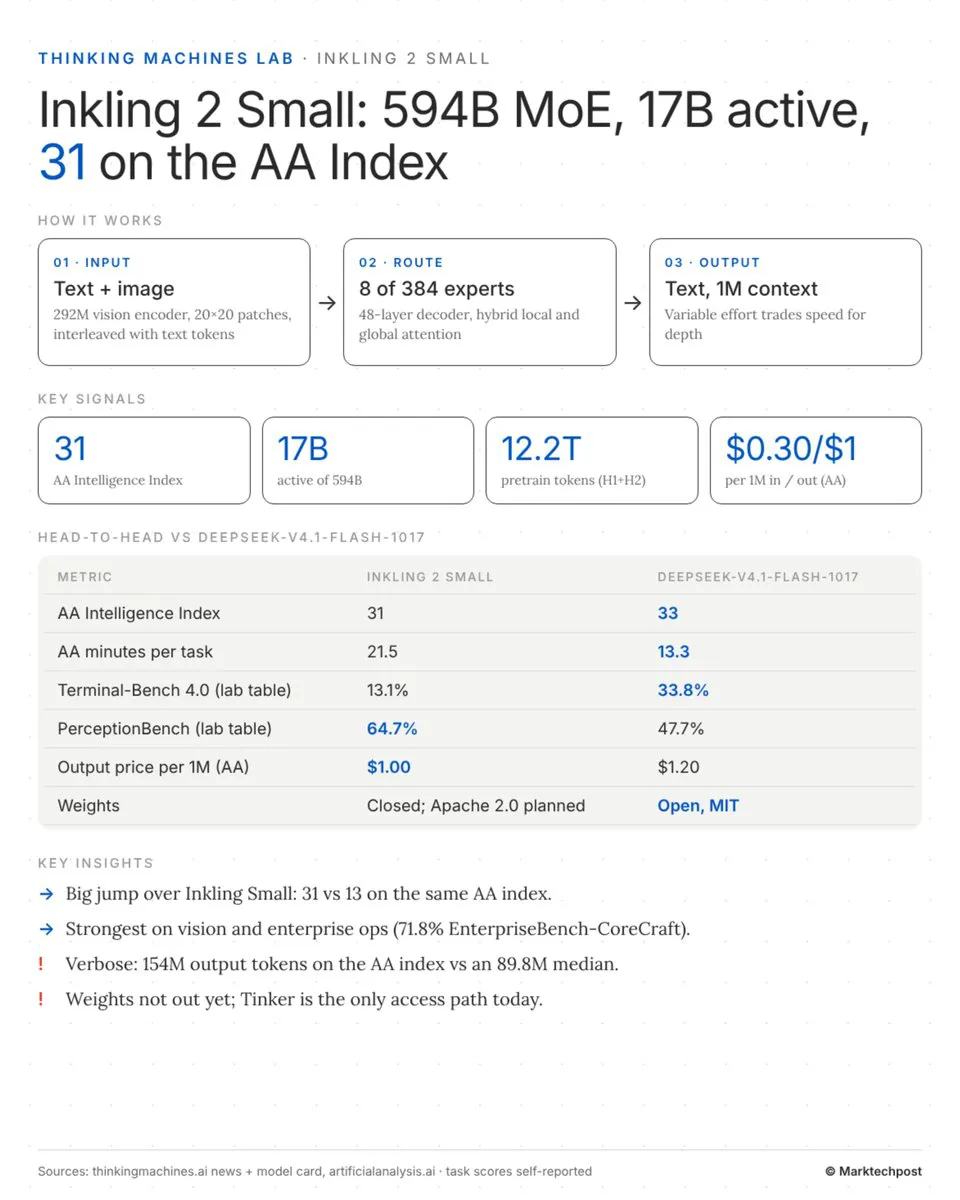
▲ Thinking Machines Lab 刚刚发布了 Inkling 2 Small,这是一个 594B 的混合专家(MoE)模型,每个 token 仅激活 17B 参数。
其核心思路是以较小的激活成本支撑庞大的专家池。每个 token 在 48 层中路由到 384 个专家中的 8 个。一个 292M 的视觉编码器将图像 patch 直接送入同一个解码器。
它在 Artificial Analysis Intelligence Index 上得分 31,相比 Inkling Small 的 13 有显著提升。DeepSeek-V4.1-Flash-1017 得分为 33,GLM-5.3-Flash 得分为 28。它在 SWE-Bench Pro v2 (Hard) 上取得 86.3%,在 PerceptionBench 上取得 64.7%。不过这是一种权衡:每个 AA index 任务耗时 21.5 分钟,而在 Terminal-Bench 4.0 上仅达到 13.1%。
它目前已在 Tinker 上线,支持微调和推理,价格为每 100 万 token 1.00。权重目前尚未公开,计划在安全测试后以 Apache 2.0 协议发布……
完整分析: