LLM 评估四大主流方法详解
本文系统梳理了大语言模型(LLM)的四种主要评估方法,旨在帮助开发者建立清晰的评估心智地图。文章结合从零开始的代码示例,深入解析基准测试、人类偏好等核心手段,并指出 MMLU 等多选题在衡量实际效用时的局限性。
报道正文
本文目录7 个章节
我们究竟如何评估 LLM?
这是一个简单的问题,但往往会引发更广泛的讨论。
在提供建议或协作项目时,我被问得最多的问题之一就是:如何在不同模型之间做出选择,以及如何解读现有的评估结果。(当然,还有如何在微调或开发自有模型时衡量进展。)
由于这个问题经常出现,我认为分享一份关于人们用于比较 LLM 的主要评估方法的简短概述可能会有所帮助。当然,LLM 评估是一个非常庞大的话题,无法在单一资源中详尽覆盖,但我认为,对这些主要方法有一个清晰的心智地图,会让解读基准测试(benchmarks)、排行榜和论文变得容易得多。
我原本计划将这些评估技术纳入我即将出版的新书 Build a Reasoning Model (From Scratch),但它们最终被认为略微超出了本书的核心范围。(本书本身更侧重于基于验证器的评估。)因此,我想将其整理成一篇较长的文章,并附带从零开始的代码示例,这样或许更好。
在 Build A Reasoning Model (From Scratch) 中,我采用了一种动手实践的方法,从零开始构建一个推理型 LLM。 如果你喜欢《Build A Large Language Model (From Scratch)》,这本书在风格上与之相似,即完全使用纯 PyTorch 从零开始构建所有内容。
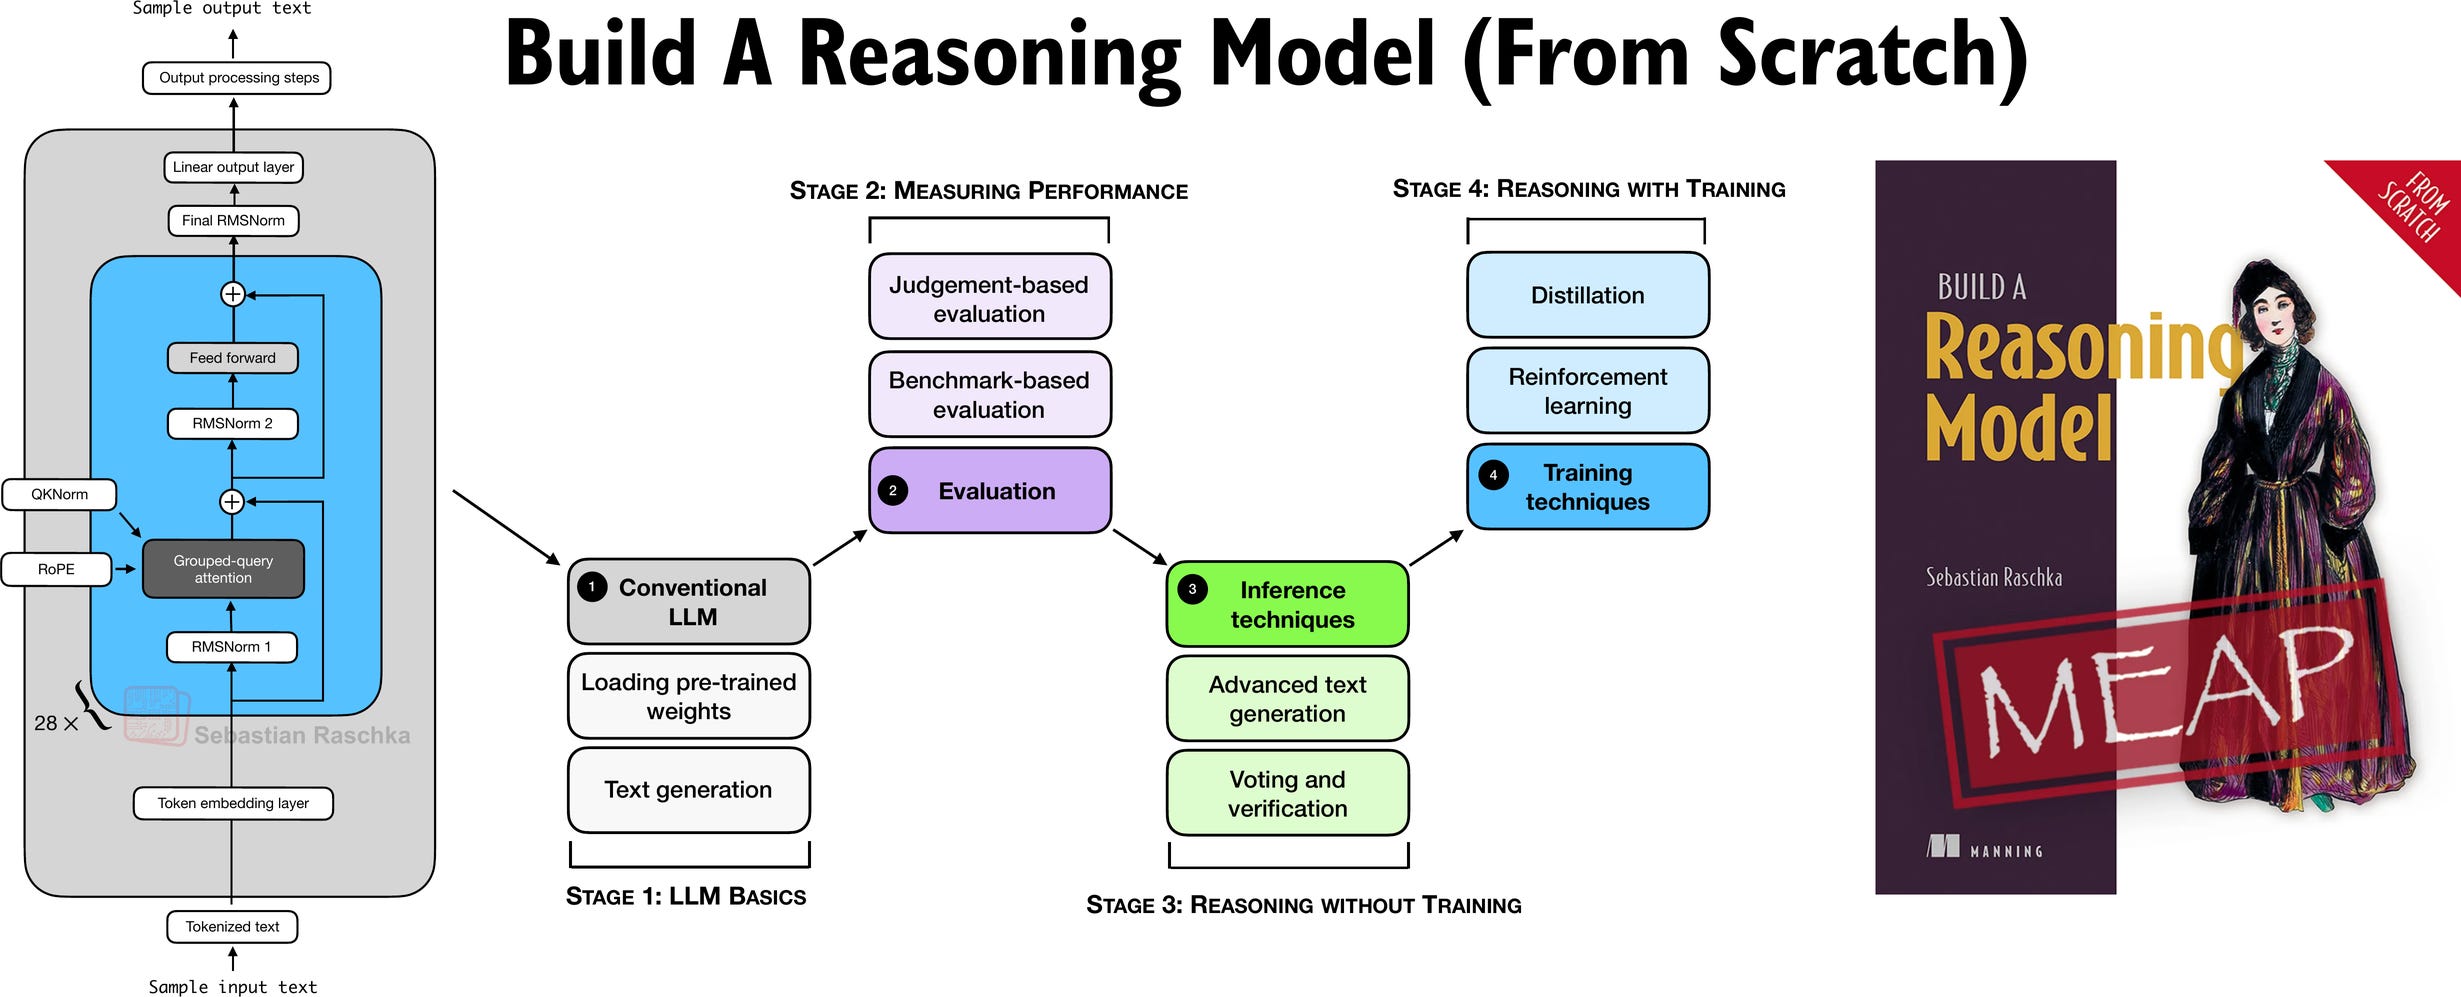 推理是近期提升 LLM 能力中最令人兴奋且最重要的进展之一,但如果仅听到“推理”这一术语并从理论上阅读相关内容,它也极易被误解。因此,在 这本书 中,我采取了一种动手实践的方式,从零开始构建一个推理型 LLM。
该书目前处于早期访问阶段,已有超过 100 页内容上线,而我刚刚又完成了另外 30 页,排版团队正在将其加入书中。如果你已加入早期访问计划(非常感谢你的支持!),当这些新页面发布时,你将收到一封电子邮件通知。
PS:目前 LLM 研究领域动态频出。我仍在努力消化不断增长的论文收藏列表,并计划在下一篇文章中重点介绍其中一些最有趣的内容。
现在,让我们探讨四种主要的 LLM 评估方法及其从零开始的代码实现,以便更好地理解它们的优势与不足。
理解 LLM 的主要评估方法
在实践中,评估训练好的 LLM 通常有四种常见方式:多选题(multiple choice)、验证器(verifiers)、排行榜(leaderboards) 和 LLM 裁判(LLM judges),如图 1 所示。研究论文、营销材料、技术报告和模型卡片(指专门针对 LLM 的技术报告)通常会包含来自这两个或更多类别的结果。
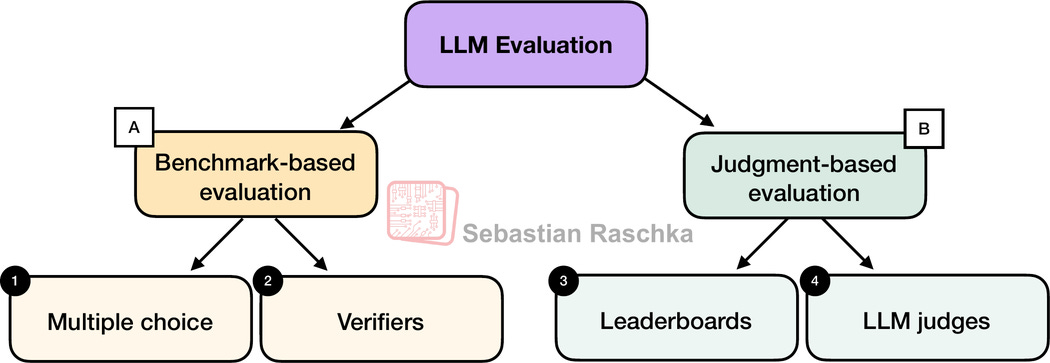
图 1:本文涵盖的 4 种不同评估模型的概览。
此外,这里介绍的四个类别可分为两组:基于基准测试的评估(benchmark-based evaluation) 和 基于判断的评估(judgment-based evaluation),如上图所示。
(还有其他衡量指标,例如 训练损失(training loss)、困惑度(perplexity) 和 奖励(rewards),但它们通常在模型开发过程中内部使用。)
以下小节将简要概述每种方法并提供示例。
方法 1:评估答案选项准确率
我们从一种基于基准测试的方法开始:多选题问答。
从历史上看,最广泛使用的评估方法之一是诸如 MMLU(Massive Multitask Language Understanding,大规模多任务语言理解,https://huggingface.co/datasets/cais/mmlu)这样的多选题基准测试。为了说明这种方法,图 2 展示了 MMLU 数据集中的一项代表性任务。
 图 2:通过将 LLM 的多选题预测结果与数据集中的正确答案进行对比,来评估其在 MMLU 上的表现。
图 2 仅展示了 MMLU 数据集中一个示例。完整的 MMLU 数据集包含 57 个学科(从高中数学到生物学),总计约 1.6 万道多选题,其性能以准确率(即正确回答问题的比例)来衡量,例如,如果 1.6 万道题中有 1.4 万道回答正确,则准确率为 87.5%。
像 MMLU 这样的多选题基准测试,以一种直观且可量化的方式检验 LLM 的知识召回能力,类似于标准化考试、许多学校考试或理论驾照考试。
请注意,图 2 展示的是多选题评估的简化版本,其中直接将模型预测的答案字母与正确答案进行比较。另外两种流行的方法涉及 对数概率评分。我在 GitHub 上实现了这些方法。(由于这基于本文解释的概念,建议在完成本文阅读后再查看。)
以下小节将演示如何用代码实现图 2 中所示的 MMLU 评分机制。
1.2 加载模型
首先,在我们将模型用于 MMLU 评估之前,必须加载预训练模型。这里,我们将使用纯 PyTorch 从零开始实现的 Qwen3 0.6B 模型,该模型仅需约 1.5 GB 内存。
请注意,Qwen3 模型的具体实现细节在此并不重要;我们只是将其视为待评估的 LLM。不过,如果你感兴趣,可以在我之前的文章 Understanding and Implementing Qwen3 From Scratch 中找到从零开始的实现指南,源代码也发布在 GitHub 上。
与其复制粘贴 Qwen3 源代码中的大量代码行,我们直接从我的 reasoning_from_scratch Python 库中导入它,该库可以通过以下方式安装:
pip install reasoning_from_scratch或者
uv add reasoning_from_scratch代码块 1:加载预训练模型
from pathlib import Path
import torch
from reasoning_from_scratch.ch02 import get_device
from reasoning_from_scratch.qwen3 import (
    download_qwen3_small, Qwen3Tokenizer,
    Qwen3Model, QWEN_CONFIG_06_B
)

device = get_device()

# Set matmul precision to "high" to
# enable Tensor Cores on compatible GPUs
torch.set_float32_matmul_precision("high")

# Uncomment the following line
# if you encounter device compatibility issues
# device = "cpu"

# Use the base model by default
WHICH_MODEL = "base"

if WHICH_MODEL == "base":
    download_qwen3_small(
        kind="base", tokenizer_only=False, out_dir="qwen3"
    )
    tokenizer_path = Path("qwen3") / "tokenizer-base.json"
    model_path = Path("qwen3") / "qwen3-0.6B-base.pth"
    tokenizer = Qwen3Tokenizer(tokenizer_file_path=tokenizer_path)

elif WHICH_MODEL == "reasoning":
    download_qwen3_small(
        kind="reasoning", tokenizer_only=False, out_dir="qwen3"
    )
    tokenizer_path = Path("qwen3") / "tokenizer-reasoning.json"
    model_path = Path("qwen3") / "qwen3-0.6B-reasoning.pth"
    tokenizer = Qwen3Tokenizer(
        tokenizer_file_path=tokenizer_path,
        apply_chat_template=True,
        add_generation_prompt=True,
        add_thinking=True,
    )

else:
    raise ValueError(f"Invalid choice: WHICH_MODEL={WHICH_MODEL}")

model = Qwen3Model(QWEN_CONFIG_06_B)
model.load_state_dict(torch.load(model_path))
model.to(device)

# Optionally enable model compilation for potential performance gains
USE_COMPILE = False
if USE_COMPILE:
    torch._dynamo.config.allow_unspec_int_on_nn_module = True
    model = torch.compile(model)
1.3 检查生成的答案字母
在本节中,我们将实现最简单且可能最直观的 MMLU 评分方法,该方法依赖于检查生成的多项选择题答案字母是否与正确答案匹配。这类似于前文图 2 中所示的内容,为方便起见,此处再次展示。
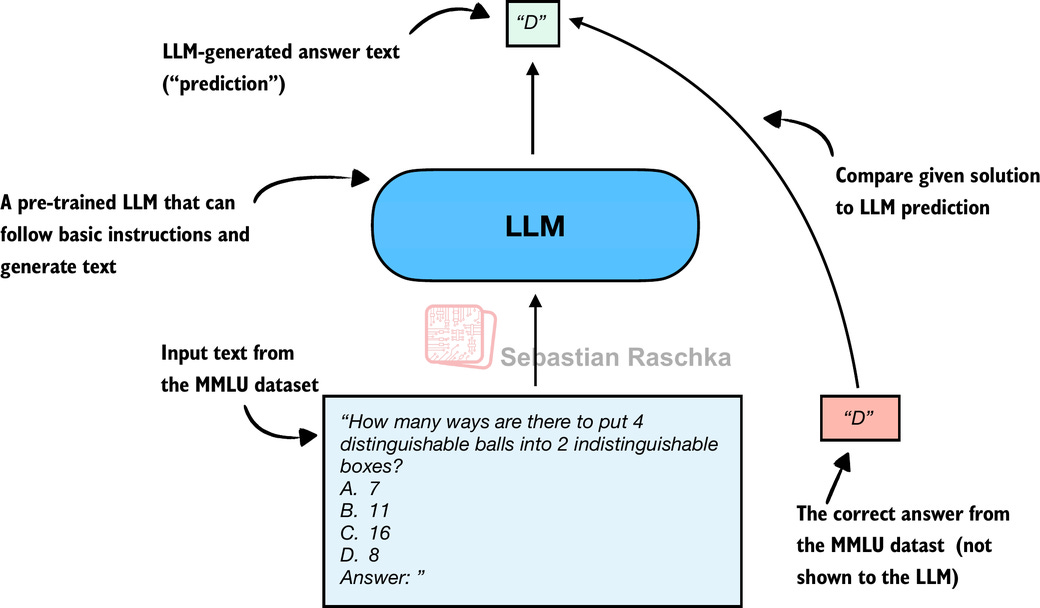 图 3:通过将 LLM 的多项选择预测结果与数据集中的正确答案进行对比,在 MMLU 上评估 LLM。
为此,我们将使用 MMLU 数据集中的一个示例:
example = {
    "question": (
        "How many ways are there to put 4 distinguishable"
        " balls into 2 indistinguishable boxes?"
    ),
    “choices”: ["7", "11", "16", "8"],
    “answer”: "D",
}
接下来,我们定义一个函数来格式化 LLM 提示词(prompt)。
代码块 2:加载预训练模型
def format_prompt(example):
    return (
        f"{example['question']}\n"
        f"A. {example['choices'][0]}\n"
        f"B. {example['choices'][1]}\n"
        f"C. {example['choices'][2]}\n"
        f"D. {example['choices'][3]}\n"
        "Answer: "
    )
# Trailing space in "Answer: " encourages a single-letter next token
让我们在 MMLU 示例上执行该函数,以了解格式化后的 LLM 输入是什么样的:
prompt = format_prompt(example)
print(prompt)
输出如下:
How many ways are there to put 4 distinguishable balls into 2 indistinguishable boxes?
How many ways are there to put 4 distinguishable balls into 2
indistinguishable boxes?
A. 7
B. 11
C. 16
D. 8
Answer:
如上所示的模型提示词向模型提供了不同答案选项的列表,并以 “Answer: “ 文本结尾,从而引导模型生成正确答案。
虽然并非严格必要,但有时提供带有正确答案的额外问题作为输入也会有所帮助,这样模型可以观察预期如何解决任务。(例如,提供 5 个示例的情况也被称为 5-shot MMLU。)然而,对于当前一代的 LLM,即使是基础模型也具备相当强的能力,因此这并非必需。
加载不同的 MMLU 样本
你可以直接通过
datasets库加载 MMLU 数据集中的示例(该库可通过pip install datasets或uv add datasets安装):文本 from datasets import load_dataset configs = get_dataset_config_names("cais/mmlu") dataset = load_dataset("cais/mmlu", "high_school_mathematics") # Inspect the first example from the test set: example = dataset["test"][0] print(example)上述代码中,我们使用了
"high_school_mathematics"子集;若要获取其他子集的列表,请使用以下代码:文本 from datasets import get_dataset_config_names subsets = get_dataset_config_names("cais/mmlu") print(subsets)
接下来,我们对提示词进行分词,并将其封装为 PyTorch 张量对象,作为 LLM 的输入:
prompt_ids = tokenizer.encode(prompt)
prompt_fmt = torch.tensor(prompt_ids, device=device)
# Add batch dimension:
prompt_fmt = prompt_fmt.unsqueeze(0)
完成所有准备工作后,我们在下面定义主要的评分函数。该函数会生成少量 token(默认情况下为 8 个),并提取模型输出的第一个 A/B/C/D 字母实例。
代码块 3:提取生成的字母
from reasoning_from_scratch.ch02_ex import (
    generate_text_basic_stream_cache
)

def predict_choice(
    model, tokenizer, prompt_fmt, max_new_tokens=8
):
    pred = None
    for t in generate_text_basic_stream_cache(
        model=model,
        token_ids=prompt_fmt,
        max_new_tokens=max_new_tokens,
        eos_token_id=tokenizer.eos_token_id,
    ):
        answer = tokenizer.decode(t.squeeze(0).tolist())
        for letter in answer:
            letter = letter.upper()
            # stop as soon as a letter appears
            if letter in "ABCD":
                pred = letter
                break
        if pred:
            break
    return pred
然后,我们可以使用上述代码块中的函数来检查生成的字母,如下所示:
pred1 = predict_choice(model, tokenizer, prompt_fmt)
print(
    f"Generated letter: {pred1}\n"
    f"Correct? {pred1 == example['answer']}"
)
结果如下:
Generated letter: C
Correct? False我们可以看到,在此情况下,生成的答案是错误的(False)。
这只是 MMLU 中 high_school_mathematics 子集的 270 个示例之一。下图(图 4)展示了基础模型和推理变体在完整子集上运行时的性能表现。相关代码可在 GitHub 获取。
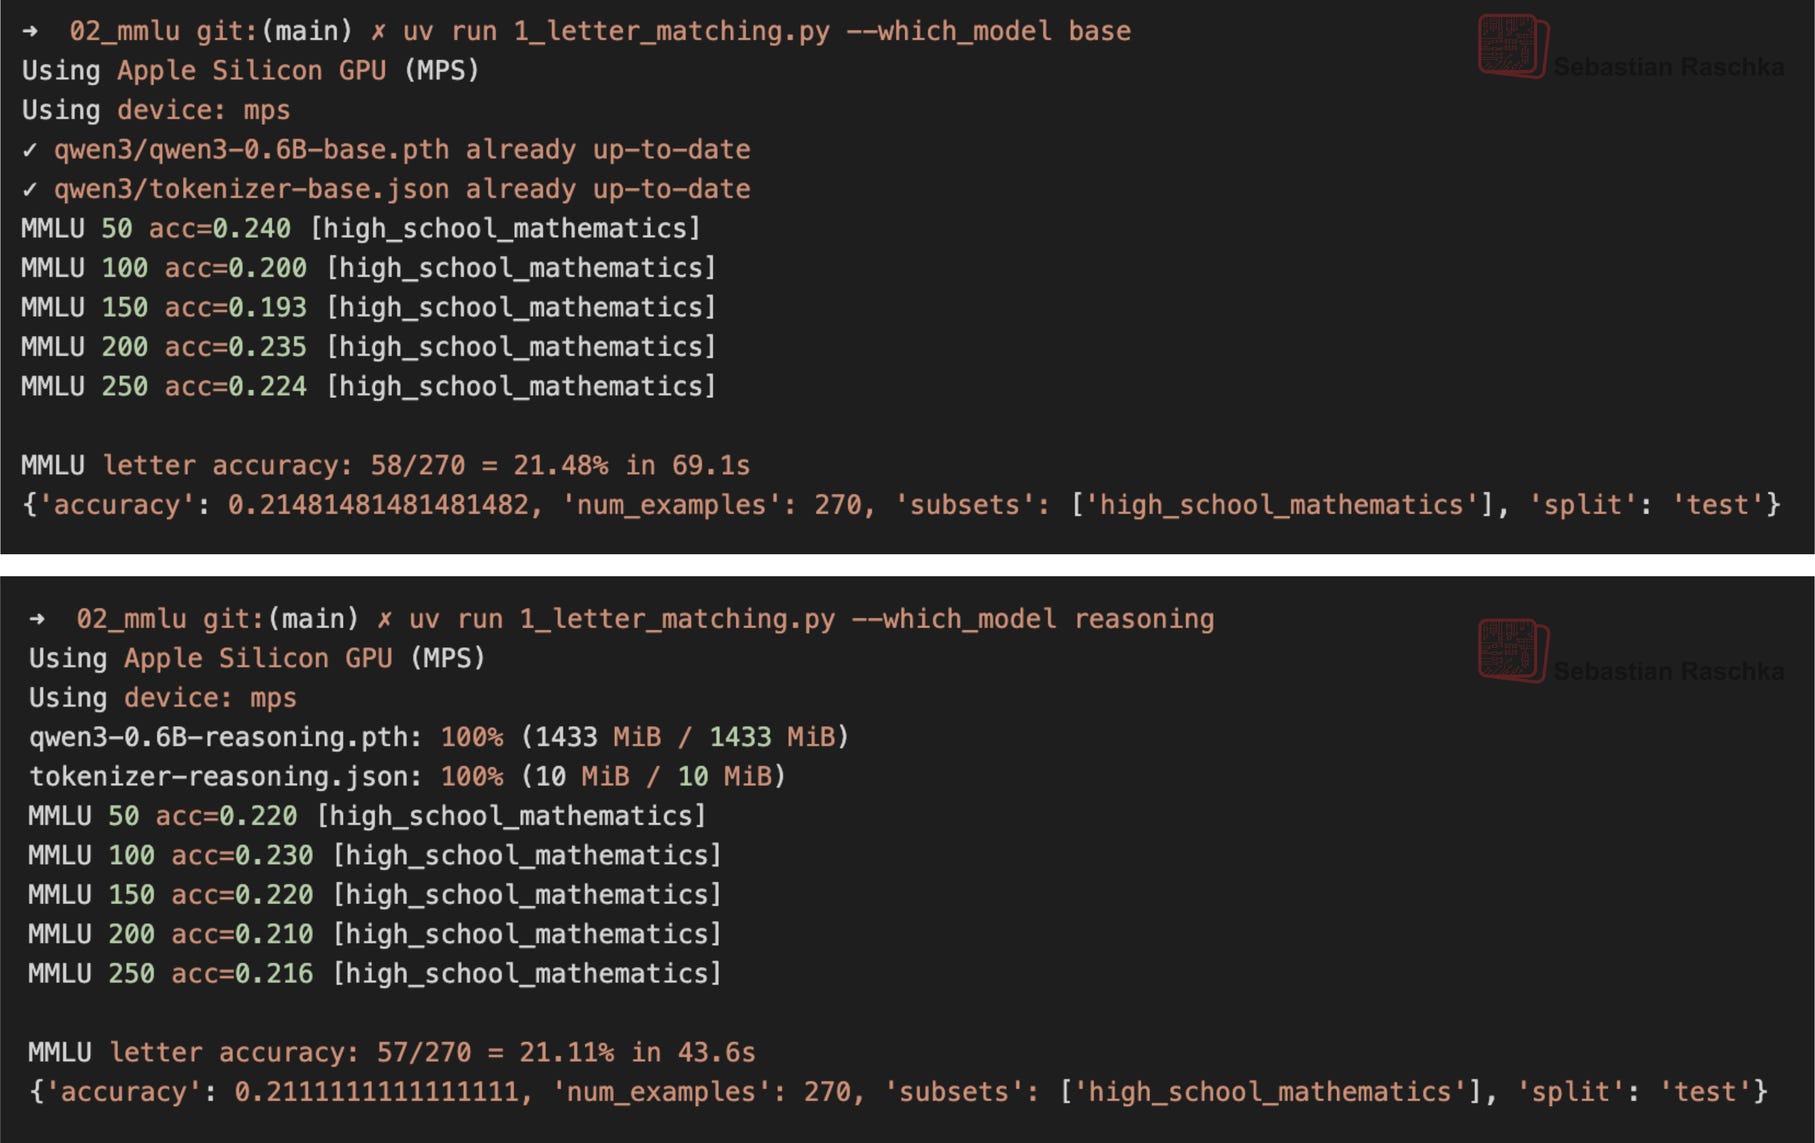 图 4:基础模型与推理模型在 MMLU
high_school_mathematics 子集上的性能表现
假设每个选项被选中的概率相等,那么随机猜测者(以均匀概率选择 A、B、C 或 D)的预期正确率为 25%。因此,无论是基础模型还是推理模型,其表现都不算太好。
多选题答案格式
请注意,本节为了实现演示目的,实现了一个简化的多选题评估版本,其中直接将模型预测的答案字母与正确答案进行比较。在实践中,存在更广泛使用的变体,例如对数概率评分(log-probability scoring),即衡量模型认为每个候选答案的可能性有多大,而不仅仅是检查最终选择的字母。(我们在第 4 章中讨论了基于概率的评分。)对于推理模型,评估还可以涉及在将正确答案作为输入提供时,评估其生成该正确答案的可能性。
图 5:其他 MMLU 评分方法已在 GitHub 上描述并分享 然而,无论我们使用哪种 MMLU 评分变体,评估仍然归结为检查模型是否从预定义的答案选项中进行选择。
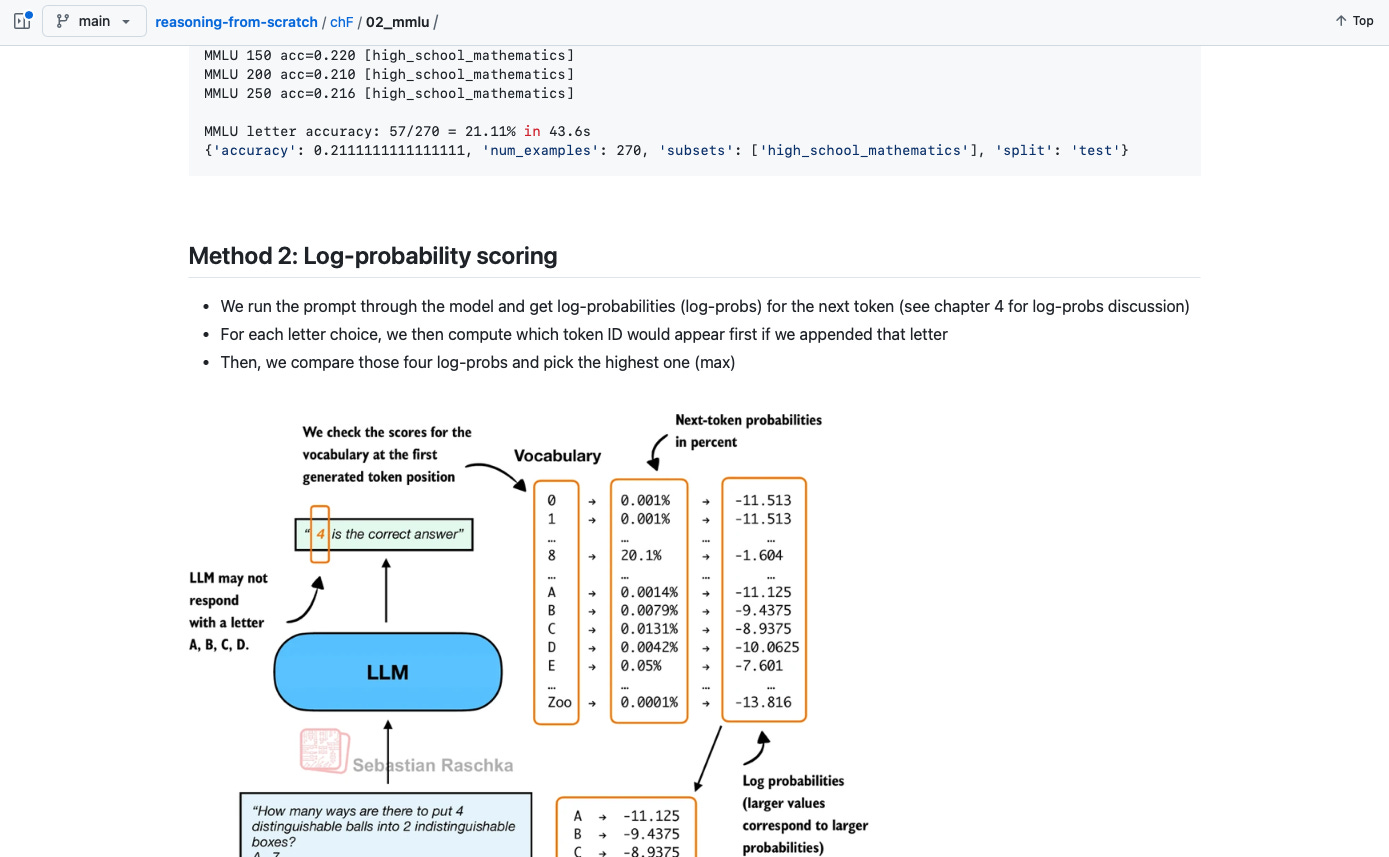
像 MMLU 这样的多选题基准测试的一个局限性在于,它们仅衡量 LLM 从预定义选项中进行选择的能力,因此除了检查模型相比基础模型遗忘多少知识以及以何种方式遗忘之外,对于评估推理能力并不十分有用。 它无法捕捉自由文本写作能力或实际应用场景中的效用。
尽管如此,多选题基准测试仍然是简单且有用的诊断工具:例如,较高的 MMLU 分数并不一定意味着模型在实际应用中表现强劲,但较低的分数可以突显潜在的知识缺口。