Rohan Paul (@rohanpaul_ai) · 2026/10/10 11:32:00
清华 TokenRouter 突破 LLM 路由瓶颈:实现每令牌大小模型动态切换,吞吐量最高提升 64.15 倍
出处作者 / 发布主体:Rohan Paul (@rohanpaul_ai)原标题:New Tsinghua paper builds TokenRouter, a serving system that runs per-token small-and-large model ro...
78AI 研判分
核心综述
清华大学推出 TokenRouter 服务系统,通过在每个令牌级别动态路由小模型与大模型,解决了传统框架中因等待慢速模型导致的阻塞问题。该系统允许模型间独立部署并共享 KV Cache,支持请求暂存以优化批处理规模,在五种路由策略下将吞吐量提升了 2.01 至 64.15 倍。
报道全文原始报道全文
Rohan Paul (@rohanpaul_ai) · 2026-10-10 03
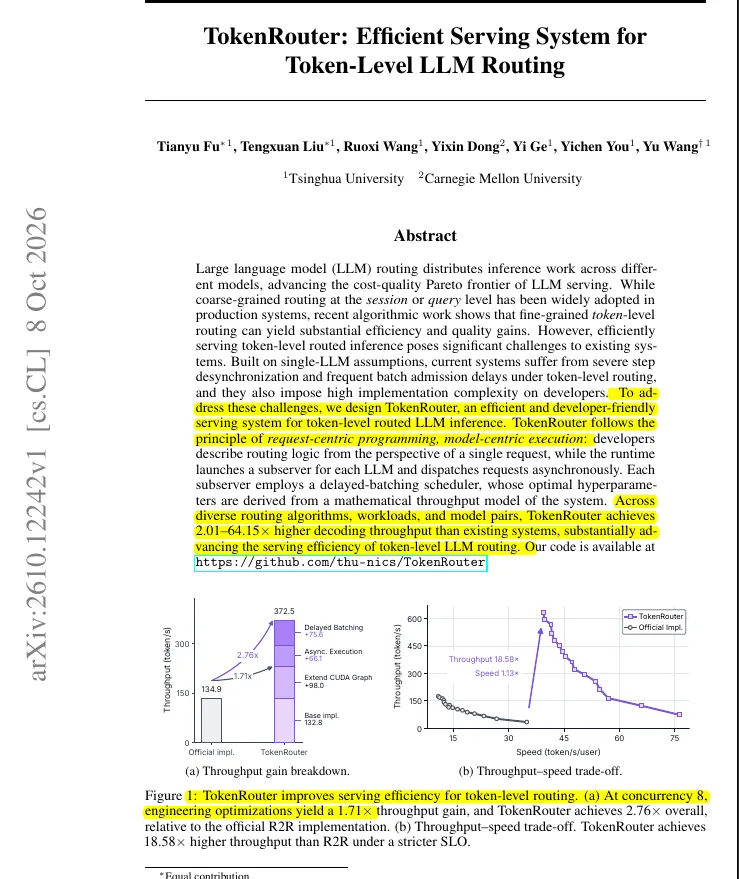
清华大学最新论文提出了 TokenRouter,这是一种服务系统,可在逐 token 大小模型路由场景下实现高达现有方案 64.15 倍的吞吐量。
当前主流的服务框架(如 vLLM 和 SGLang)对每个请求仅运行一个模型,因此当两个模型共享答案时,每一步都必须等待较慢的那个模型完成。
TokenRouter 为每个模型分配独立的服务器,并允许它们在任务之间灵活切换。它可以在两个模型间传递部分生成的答案,同时保留模型对已生成文本的上下文记忆(即 KV cache),并通过短暂缓冲请求来使每个模型处理更大的批次。
在 5 种路由方法中,相较于更强的现有配置,吞吐量提升了 2.01 至 64.15 倍。
– arxiv. org/abs/2610.12242
标题:"TokenRouter: Efficient Serving System for Token-Level LLM Routing"